IA: construire un harness Claude Code sans outils externes + bonus économie de tokens
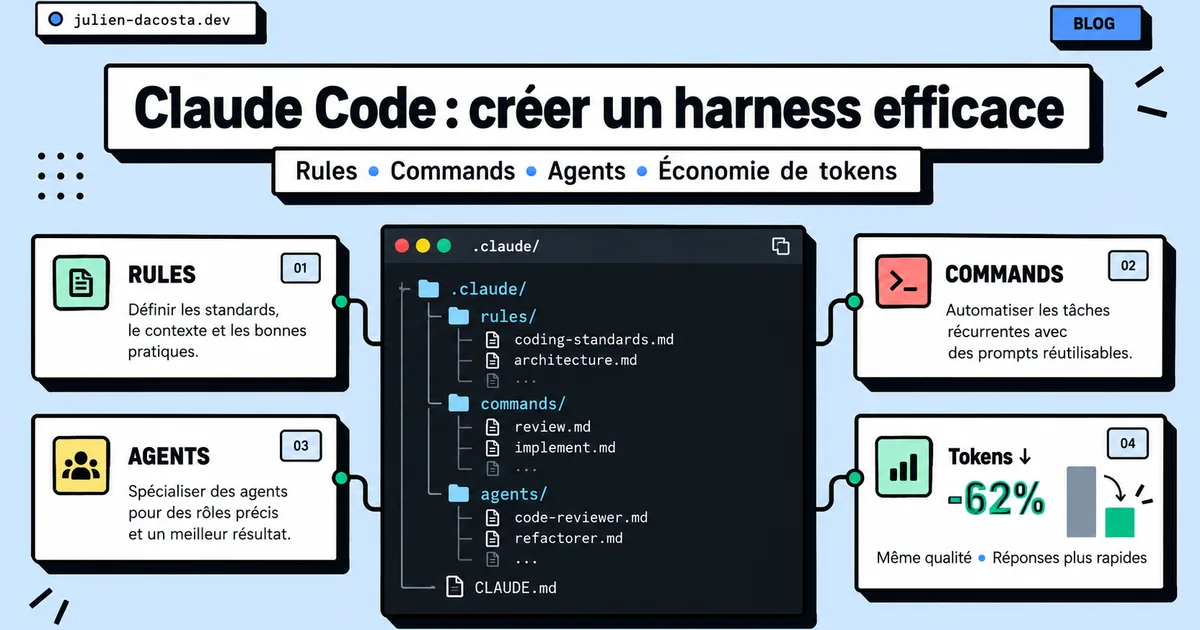
Optimisez votre utilisation de Claude Code avec des rules, commands et agents personnalisés, et découvrez en bonus comment réduire votre consommation de tokens.
IA: construire un harness Claude Code sans outils externes + bonus économie de tokens
C’est un fait le développement logiciel s’est complètement transformé ces dernières années avec l’arrivée de l’IA et d’outils comme Claude Code ou Codex.
Aujourd’hui ignorer complètement ces technologies lorsqu’on développe revient à se priver d’un gain de productivité considérable.
Cependant beaucoup de développeurs utilisent encore ces outils de manière assez peu optimale dans leurs projets.
Dans cet article nous allons voir comment aller plus loin avec Claude Code en construisant directement dans votre projet une sorte de harness, c’est-à-dire un environnement composé de règles, de commandes, d’agents spécialisés et de documentation permettant de guider Claude en permanence.
Il n’est pas forcément nécessaire d’ajouter des outils externes complexes. Une grande partie de cette logique peut être construite directement dans votre repo à l’aide de simples fichiers Markdown que Claude peut lire et utiliser comme contexte.
À retenir :
- Structurez Claude Code directement dans votre projet avec .claude/rules, .claude/commands et .claude/agents afin d’éviter de répéter constamment les mêmes instructions.
- Transformez les erreurs récurrentes en règles permanentes si Claude ne respecte pas une convention, corrigez-le une fois puis faites-en une règle réutilisable.
- Une commande doit représenter un workflow les tâches répétitives comme une nouvelle feature frontend/backend gagnent à devenir des commandes dédiées plutôt que des prompts copiés-collés.
- Spécialisez vos agents selon les domaines et les tâches, avec le bon modèle et le bon niveau d’effort, afin de mieux contrôler la qualité, le coût et la consommation de tokens.
- Optimisez l’exploration de la codebase avec un outil comme CodeGraph pour limiter les lectures inutiles de fichiers et réduire le nombre d’appels outils ainsi que la consommation de tokens.
Le dossier .claude
Vous pouvez créer un dossier .claude à la racine de votre projet.
À l’intérieur plusieurs sous-dossiers peuvent être utilisés pour organiser le comportement de Claude Code:
- rules: contient les règles que Claude doit respecter. C’est en quelque sorte votre guide de développement permanent ce qui évite de répéter les mêmes instructions à chaque conversation.
- commands: permet de créer vos propres slash commands.
- agents: permet de définir des agents spécialisés dans certaines tâches. Claude pourra ensuite utiliser l’agent approprié lorsque cela est nécessaire.
Tout cela permet de simplifier considérablement le workflow de développement.
Vous n’avez plus besoin de vous répéter constamment ni de conserver quelque part "le bon prompt" à envoyer. Le fonctionnement du projet devient progressivement standardisé.
C’est également très utile lorsque plusieurs développeurs travaillent sur le même repo, chacun bénéficie des mêmes règles, des mêmes workflows et de la même organisation.
mon-projet/
├── .claude/
│   ├── settings.json
│   ├── rules/
│   │   ├── frontend.md
│   │   ├── backend.md
│   │   └── database.md
│   ├── commands/
│   │   ├── review.md
│   │   └── new-feature.md
│   └── agents/
│       ├── frontend-expert.md
│       ├── backend-expert.md
│       └── reviewer.md
├── CLAUDE.md
└── ...
Le dossier .claude/rules
Claude Code ne respecte pas toujours parfaitement certaines conventions propres à une application ou à une équipe.
Le dossier rules permet justement de lui imposer ces conventions.
Au lieu de placer toutes les instructions dans un énorme fichier CLAUDE.md vous pouvez les découper en plusieurs fichiers Markdown spécialisés.
Par exemple :
.claude/rules/
├── backend-architecture.md
├── frontend-conventions.md
├── database.md
├── typescript-conventions.md
└── testing.md
Comment créer une règle ?
Vous n’avez même pas besoin de l’écrire vous-même.
Lorsqu’un comportement de Claude ne respecte pas une convention de votre projet:
1 - vous lui montrez ce qui ne va pas
2 - vous lui expliquez la convention que vous souhaitez appliquer
3 - vous lui demandez de créer une règle afin de ne plus reproduire cette erreur.
Le harness se construit ainsi progressivement à partir des problèmes réellement rencontrés pendant le développement.
Voici un exemple typique issu de mes projets.
Dans un projet TypeScript je n’aime pas avoir des types contenant plusieurs propriétés partageant le même préfixe lorsqu’elles appartiennent au même domaine.
Je préfère regrouper ces informations dans des sous-objets.
À ne pas faire
type Stats = {
  collaborativeCount: number
  collaborativePercentage: number
  personalCount: number
  personalPercentage: number
}
À faire
type Stats = {
  collaborative: {
    count: number
    percentage: number
  }
  personal: {
    count: number
    percentage: number
  }
}
Claude reproduisait parfois ce premier pattern. Je lui ai donc expliqué la convention souhaitée, puis je lui ai simplement demandé de générer une règle afin qu’il ne recommence plus.
Voici la règle générée par Claude lui-même après lui avoir donné un exemple de ce que je souhaitais.
L’intérêt est important, au lieu de corriger Claude dix fois sur le même problème vous corrigez le comportement une seule fois et transformez cette correction en règle permanente.
Le dossier .claude/agents
Documentation officielle d’Anthropic :
https://code.claude.com/docs/fr/sub-agents#quickstart-create-your-first-subagent
Les agents permettent de créer des contextes spécialisés dans certaines tâches précises.
Chaque agent peut disposer de ses propres instructions, de ses propres responsabilités et de son propre périmètre.
Claude peut ensuite utiliser l’agent spécialisé lorsque la tâche le nécessite.
Et c’est là que le système devient particulièrement intéressant.
Vous pouvez notamment définir :
- les outils auxquels l’agent a accès
- le modèle utilisé
- le niveau d’effort autorisé
- les instructions spécifiques à son domaine.
Le fait de pouvoir choisir le modèle utilisé par chaque agent est particulièrement puissant.
Vous pouvez par exemple, utiliser un modèle très performant pour analyser une demande complexe, puis déléguer certaines sous-tâches plus simples à des agents utilisant des modèles moins coûteux.
Cela évite d’utiliser systématiquement le meilleur modèle avec l’effort maximal pour des tâches qui ne le nécessitent pas.
Vous obtenez ainsi un workflow potentiellement plus rapide et moins coûteux en tokens.
Bien découper ses agents
Chaque agent doit correspondre à un scope relativement précis.
Dans mes repositories j’ai longtemps utilisé principalement deux agents :
- frontend ;
- backend.
Cela fonctionne mais ce découpage reste assez large.
Selon la taille du projet, il peut être intéressant d’aller plus loin :
agents/
├── backend.md
├── frontend.md
├── database.md
├── reviewer.md
├── testing.md
└── security.md
Chaque agent connaît alors précisément son domaine et les contraintes associées.
Voici un exemple de mon agent frontend.
Le dossier .claude/commands
Les commandes permettent de créer vos propres commandes /... directement utilisables dans Claude Code.
L’objectif est simple: transformer un prompt répétitif en workflow réutilisable.
Au lieu de conserver plusieurs prompts dans un fichier à côté de votre projet et de les copier-coller à chaque nouvelle tâche, vous créez une commande dédiée.
Par exemple dans mes projets séparant frontend et backend, j’utilise généralement des commandes de ce type :
- /new-feature: fonctionnalité nécessitant des modifications frontend et backend
- /feature-frontend: fonctionnalité uniquement frontend
- /feature-backend: fonctionnalité uniquement backend
Chacune de ces commandes peut contenir :
- différentes étapes ;
- des recommandations ;
- des vérifications obligatoires ;
- des références vers les règles du projet ;
- l’appel à un ou plusieurs agents spécialisés.
Par exemple, /new-feature peut commencer par lancer un agent backend.
Une fois la partie backend terminée, le workflow peut ensuite appeler l’agent frontend pour construire l’interface correspondante.
Voici un exemple de ma commande /new-feature.
L’idée essentielle à retenir est la suivante :
une commande = un workflow.
Au lieu d’utiliser sans cesse des prompts enregistrés quelque part, vous transformez vos processus de développement récurrents en commandes directement intégrées au projet.
Cela permet d’obtenir quelque chose de beaucoup plus reproductible.
Le fichier CLAUDE.md
Une fois les règles, commandes et agents correctement organisés, votre fichier CLAUDE.md peut devenir beaucoup plus léger.
Vous n’avez plus besoin d’y placer toutes les conventions du projet.
Les règles vivent dans .claude/rules, les commandes dans .claude/commands et les agents dans .claude/agents.
CLAUDE.md peut alors principalement servir de point d’entrée permettant à Claude de comprendre l’organisation générale.
Vous pouvez même demander directement à Claude de mettre à jour votre fichier CLAUDE.md afin qu’il référence correctement votre système .claude.
Personnellement j’utilise quelque chose de ce type à la fin de mon fichier :
## Workflow feature — Commandes `/project:` Utilise ces commandes depuis la racine pour développer des features sans naviguer entre les dossiers : | Commande | Description | |---|---| | `/project:new-feature" "` | Feature full-stack : doc backend + implémentation backend + implémentation frontend | | `/project:feature-backend " "` | Backend uniquement : document de contrat + implémentation | | `/project:feature-frontend ` | Frontend uniquement : depuis un contrat existant dans `backend/docs/features/` | ## Architecture et guidelines **Toutes les règles du projet vivent dans `.claude/rules/*.md` — source unique de vérité.** Ne pas recopier leur contenu ni en tenir une liste ailleurs. Lis celles qui concernent ton périmètre, identifiées par le **préfixe du nom de fichier** : - `backend-*.md` — règles backend (AdonisJS : architecture, guidelines tests/docs/checklist PR, services IoC, etc.) - `frontend-*.md` — règles frontend (Vue 3 : architecture, gestion des erreurs API, dates, Vue Query, etc.) - tout autre nom (`codegraph.md`, `typescript-conventions.md`, `general-conventions.md`, etc.) — règles **transverses**, applicables partout. Les commandes `/project:*` chargent automatiquement les fichiers pertinents. **Ajouter une règle** = déposer un `.md` dans `.claude/rules/` en respectant ce préfixe. Aucun `CLAUDE.md` ni `AGENTS.md` à modifier. --- ## Structure `.claude/` .claude/ commands/ new-feature.md # /project:new-feature — workflow full-stack feature-backend.md # /project:feature-backend — backend uniquement feature-frontend.md # /project:feature-frontend — frontend depuis contrat rules/ # règles projet — découvertes par préfixe *.md agents/ backend.md # Sous-agent backend frontend.md # Sous-agent frontend settings.json
Bonus: réduire la consommation de tokens avec CodeGraph
Vous l’avez probablement déjà remarqué: Claude Code peut consommer énormément de tokens simplement pour comprendre la structure d’une codebase.
Avant même de commencer réellement une tâche, il peut effectuer de nombreux appels avec des outils comme grep, glob ou read afin d’explorer les fichiers et de reconstruire progressivement une représentation mentale du projet.
Sur une grosse codebase cela peut représenter beaucoup d’allers-retours.
Il existe cependant des outils permettant de réduire fortement cette phase d’exploration.
L’un de ceux que j’utilise personnellement sur mes projets est CodeGraph.
Que fait CodeGraph ?
CodeGraph construit localement un graphe de connaissance de votre code.
Il peut notamment indexer :
- les symboles ;
- les fonctions ;
- les classes ;
- les relations entre fonctions ;
- les dépendances entre fichiers ;
- les chemins d’exécution ;
- les relations cross-file ;
- l’impact potentiel d’une modification.
L’agent peut ensuite interroger directement ce graphe.
Au lieu d’ouvrir successivement plusieurs dizaines de fichiers pour comprendre où se trouve une fonctionnalité, il peut poser une requête et récupérer directement les morceaux de code pertinents ainsi que les relations entre eux.
Cela permet également d’évaluer plus rapidement le blast radius potentiel d’une modification.
Le développeur de CodeGraph annonce notamment :
- 88 % d’appels outils en moins ;
- 53 % de rapidité supplémentaire ;
- 62 % de tokens traités en moins ;
- 44 % de coût en moins.
De mon côté j’ai effectivement constaté sur certains projets une baisse importante du coût lié à l’exploration de la codebase.
Je recommande donc de tester ce type d’approche particulièrement sur des repositories importants.
Vous pouvez ensuite l’intégrer directement dans votre harness Claude à l’aide d’une règle.
Par exemple :
# CodeGraph — Règle obligatoire

Avant toute exploration de code, vérifier si `.codegraph/` existe dans le répertoire de travail.

## Si `.codegraph/` existe

Utiliser CodeGraph **en premier** — jamais `grep`, `find`, `rg`, `ls` récursif ou des lectures massives de fichiers.

Un seul outil : `codegraph_explore`.

Il prend une question en langage naturel ou un ensemble de noms de symboles/fichiers et retourne en un seul appel :

- le code source des symboles concernés ;
- les fichiers associés ;
- leurs appelants et appelés ;
- le rayon d’impact potentiel d’un changement.

Il permet notamment de répondre à des questions comme :

- Où est `X` défini ?
- Qu’est-ce qui appelle `Y` ?
- Quel serait l’impact d’une modification de `Z` ?
- Montre-moi le code de `Y`.
- Cartographie cette zone du projet.
- Explore ce module.
- Quels fichiers sont présents dans ce chemin ?

### Règles

- Faire confiance aux résultats CodeGraph issus du parsing AST et éviter de les re-vérifier systématiquement avec `grep`.
- Un seul appel `codegraph_explore` doit généralement suffire lorsqu’il couvre déjà le besoin.
- Éviter les appels successifs inutiles pour affiner une réponse déjà suffisante.
- Les lectures directes de fichiers ne sont autorisées qu’**après** une requête CodeGraph, afin de vérifier un détail qui ne serait pas couvert.
- L’index peut avoir environ 500 ms de retard après une écriture de fichier : éviter de relancer immédiatement une requête après une modification.

## Si `.codegraph/` n’existe pas

Ne pas explorer massivement le repository.

Demander ou exécuter :

`codegraph init -i`

avant l’analyse, sauf urgence explicite.
Puis ajoutez simplement une référence vers cette règle dans votre CLAUDE.md :
## Règles — CodeGraph

@.claude/rules/codegraph.md
Ainsi, Claude sait immédiatement que CodeGraph doit être privilégié lorsqu’il est disponible.
Conclusion
Ce qu’il faut surtout comprendre, c’est qu’un bon harness Claude Code ne se construit pas forcément en une seule fois.
Et ce n’est probablement même pas souhaitable.
Passer plusieurs jours à essayer d’anticiper toutes les règles, tous les agents et tous les workflows possibles avant même de commencer à développer serait souvent une perte de temps, d’argent et d’énergie.
Le meilleur harness est généralement celui qui évolue progressivement avec le projet.
Claude Code est déjà capable de comprendre et de conserver certaines conventions simplement grâce au contexte du repo.
Tant qu’il respecte naturellement une convention, il n’est pas forcément nécessaire de créer une règle supplémentaire.
En revanche lorsqu’un problème revient régulièrement transformez sa correction en règle.
Lorsqu’un prompt revient constamment transformez-le en commande.
Lorsqu’un domaine nécessite un contexte ou un raisonnement spécifique transformez-le en agent spécialisé.
Petit à petit votre projet finit par construire son propre environnement de développement assisté par IA.
Et c’est probablement là que se trouve l’un des plus gros gains de productivité avec Claude Code: ne plus simplement utiliser un agent de code, mais construire autour de lui un système adapté à votre manière de développer.